- 发布时间
模型便宜,任务却不便宜:一次 67 元的 OpenCode Go 试用
- 我们想找的是替代方案,不是再做一次跑分
- 为什么开始寻找 GPT 和 Claude 之外的选择
- 67 元的 OpenCode Go 试用
- 一个 iKanban 任务意味着什么
- DeepSeek Flash 能解决这个问题吗
- 套餐与 API 的兑换倍率,要先定义清楚
- 不只是继续加钱
- 结论
- 来源与相关文章
我们想找的是替代方案,不是再做一次跑分
我们花了 67 元试用 OpenCode Go,希望给 GPT 和 Claude 订阅找一个日常可用的替代方案。结果,在自己的 iKanban 项目里处理一个中等复杂度的 issue,Kimi K3 大约消耗了月度配额的 5%。用 GPT-6.1 Sol 处理一个相近任务,大约消耗的是 ChatGPT Plus 周配额的 1%。
这两个百分比对应不同的时间窗口。把它们换算成一个月能做多少任务之后,差距就很明显了:Kimi 约 3.35 元一次,GPT 约 0.335 元一次。
这不是严格控制变量的模型评测,而是一次影响了我们续费意愿的本地成本比较。还没有开始讨论能力、速度和延迟,我们就先遇到了一个更基本的问题:这个方案能不能负担得起日常使用?
为什么开始寻找 GPT 和 Claude 之外的选择
最近几天,我们尝试了更高用量的 GPT Pro 和 Claude Max,也就是 5x 档位。但 Claude 账号用了大约一天就被封禁了。我们怀疑这可能与本地访问环境有关,不过并没有得到确认。账号被封是实际发生的事,具体原因仍然不清楚。
在失去 Claude 后重建工作流那篇文章里,我们已经讨论过:模型不可用了,不代表围绕它积累的工具和方法也要全部推倒。OpenCode 和 iKanban 让工作还能继续。但工具可迁移,不能直接解决模型访问本身的问题。
GPT 带来的是另一种担忧:有时服务表现比我们选择的模型更弱,让人怀疑 GPT-6 会不会回退到 GPT-5.5,甚至更便宜的模型。我们没有验证过是否存在静默替换模型,仅凭一次输出变差,也不能证明服务降级。上下文、推理设置、路由和模型自身的波动,都可能影响结果。不过,不确定自己实际拿到什么服务,确实会影响对订阅的信任。
所以,我们开始考虑 Kimi K3、GLM-5.3 和 DeepSeek V4。我们需要的是访问和支付更方便,同时又不会让每个稍微复杂的任务都显得昂贵的方案。
67 元的 OpenCode Go 试用
最早是在 Bilibili 视频里看到有人推荐 Go。吸引我们的理由很直接:可以访问多个国产模型,比直接买 API 有更多用量,而且能通过支付宝用人民币付款。我们为这次试用支付了 67 元。这是自己的实际付款金额,不代表所有用户都有相同的人民币价格或支付方式。
目前,OpenCode Go 官方文档列出的价格是 Go 每月 10 美元,Go Plus 每月 40 美元。但套餐不是给所有模型统一发放同样的廉价用量,而是按模型设置不同额度。
与这次比较最相关的几个模型,在基础 Go 套餐里的额度如下:
| 模型 | 每月计费用量额度 | 额度 ÷ 10 美元订阅费 |
|---|---|---|
| Kimi K3 | 15 美元 | 1.5 倍 |
| GLM-5.3 | 15 美元 | 1.5 倍 |
| DeepSeek V4 Pro | 15 美元 | 1.5 倍 |
| Kimi K2.7 Code | 60 美元 | 6 倍 |
| GLM-5.3-Flash | 60 美元 | 6 倍 |
| DeepSeek V4.1 Flash | 80 美元 | 8 倍 |
这是一份在 2026 年 10 月 12 日核对的价格快照,按 Go 公布的 token 费率计量。这些额度不是现金余额,也不是保证能完成的任务数。文档还规定了 5 小时和每周限制,分别为月额度的 20% 和 50%。不同模型的额度,也不能直接当成一个可以任意兑换的统一余额。
OpenCode 对差异给出了解释:一些模型可以通过批量折扣和预留算力获得更大的用量;新模型或暂时没有这些折扣的模型,额度就更少。这个解释可以理解,但它也改变了购买判断。能访问很多模型,不等于我们真正想用的那个模型有足够的额度。
一个 iKanban 任务意味着什么
这次测试是在自己的 iKanban 项目里处理一个中等复杂度的 issue。Kimi K3 会话显示的计费用量约为 0.67 美元,月配额消耗约为 5%。
按百分比做一个简单估算:
Kimi K3:100% ÷ 5% ≈ 每月 20 个相近任务
订阅费摊销:67 元 ÷ 20 ≈ 每个任务 3.35 元
这里需要保留一个小差异:按目前公布的 15 美元额度,0.67 美元对应的是 4.47%,并不正好是 5%。如果按金额计算,则大约能做 22 个任务,每次约 2.99 元。没有更详细的记录,我们无法进一步解释面板百分比与计费金额的差异。无论采用哪个数字,结果都是二十来个任务,而不是几百个。
GPT-6.1 Sol 处理相近任务时,我们观察到的消耗约为 Plus 周配额的 1%:
GPT:100% ÷ 1% ≈ 每周 100 个相近任务
按四周估算:100 × 4 ≈ 400 个任务
订阅费摊销:20 美元 ÷ 400 = 每个任务 0.05 美元
沿用这次 Go 付款隐含的换算比例,即每美元 6.7 元,0.05 美元就是 0.335 元。这是为了统一比较所采用的假设,不是实时汇率,也不代表我们实际购买 Plus 的结算金额。
| 比较项 | Go 中的 Kimi K3 | Plus 中的 GPT-6.1 Sol |
|---|---|---|
| 观察到的配额消耗 | 约为月额度的 5% | 约为周额度的 1% |
| 推算的四周任务数 | 约 20 个 | 约 400 个 |
| 月费计算基础 | 实付 67 元 | 标价 20 美元,按 134 元计算 |
| 单任务订阅费摊销 | 约 3.35 元 | 约 0.335 元 |
对这类任务而言,估算得到的是大约 10 倍的成本差距。但这不意味着每提交一个 issue,GPT 就扣掉 0.335 元。这两个数字都是把固定订阅费分摊到假定能用满的任务量上。实际完成的任务更少,每个完成任务分摊到的成本就更高。
这个比较还假设整个月的任务消耗相近、没有其他用途争抢配额,也没有更紧的时间窗口先成为瓶颈。上下文、缓存、重试和推理用量都会改变消耗。OpenAI 的 Codex 定价文档也明确区分了 API 价格与订阅内用量,不能把它们简单当成固定任务数。
即使有这些限制,这次观察也足以让我们重新考虑是否要把 Go 作为主要的 Kimi 使用方案。判断自己的预算是否够用,不需要先证明一个对所有人都成立的结论。
DeepSeek Flash 能解决这个问题吗
有人建议改用 DeepSeek V4.1 Flash,认为处理相近任务可能只要 0.3 元左右。如果成立,就接近我们的 GPT 成本估算。但这是别人给出的建议,不是我们在这次比较里复现的结果。
从价格方向看,这个说法有一定依据。DeepSeek 官方价格列出的 V4.1 Flash 非高峰费率,是每百万未缓存输入 token 0.15 美元、每百万输出 token 0.60 美元,高峰时段价格翻倍。缓存输入还要更便宜。Go 给它的额度也明显高于 Kimi K3。
但我们担心,对于真正想交给模型的复杂工作,Flash 相比 GPT-6.1 Sol 会损失太多能力。这是我们的判断,并不是这次成本测试测出来的能力差距。便宜模型当然可能适合边界清晰的简单任务,但不能因此直接视为主力模型的替代品。
更有用的指标是每个通过验收的任务成本,把重试和人工修正也算进去,而不只是每百万 token 的价格。只有能以可接受的质量完成需要的工作,低 token 单价才真正有意义。
套餐与 API 的兑换倍率,要先定义清楚
最初,我们把 Kimi 的套餐价值形容成「几乎 1:1」。按现在公布的额度,准确一些应该是 1.5 倍。比直接按量消费多了一些,但离我们期待的订阅优势还是很远。
为了避免把比例写反,这里统一定义:
价值倍率 = API 等效用量价值 ÷ 订阅费
反过来,用订阅费除以 API 价值,得到的是成本比例,而不是价值倍率。
我们原本的粗略预期是:Go 大约 2–8 倍,GPT/Claude 编程订阅大约 35–50 倍。本次核对的 Go 数据,把相关模型的范围修正为 1.5–8 倍。而 35–50 倍仍然只是我们的工作估算,不是官方公布的额度,也不是这一个任务能够证明的结果。要验证它,需要完整的 token 日志、对应模型的 API 费率、缓存计费,以及跨完整重置周期的实际用量记录。仅凭任务消耗的百分比,无法推出这个倍率。
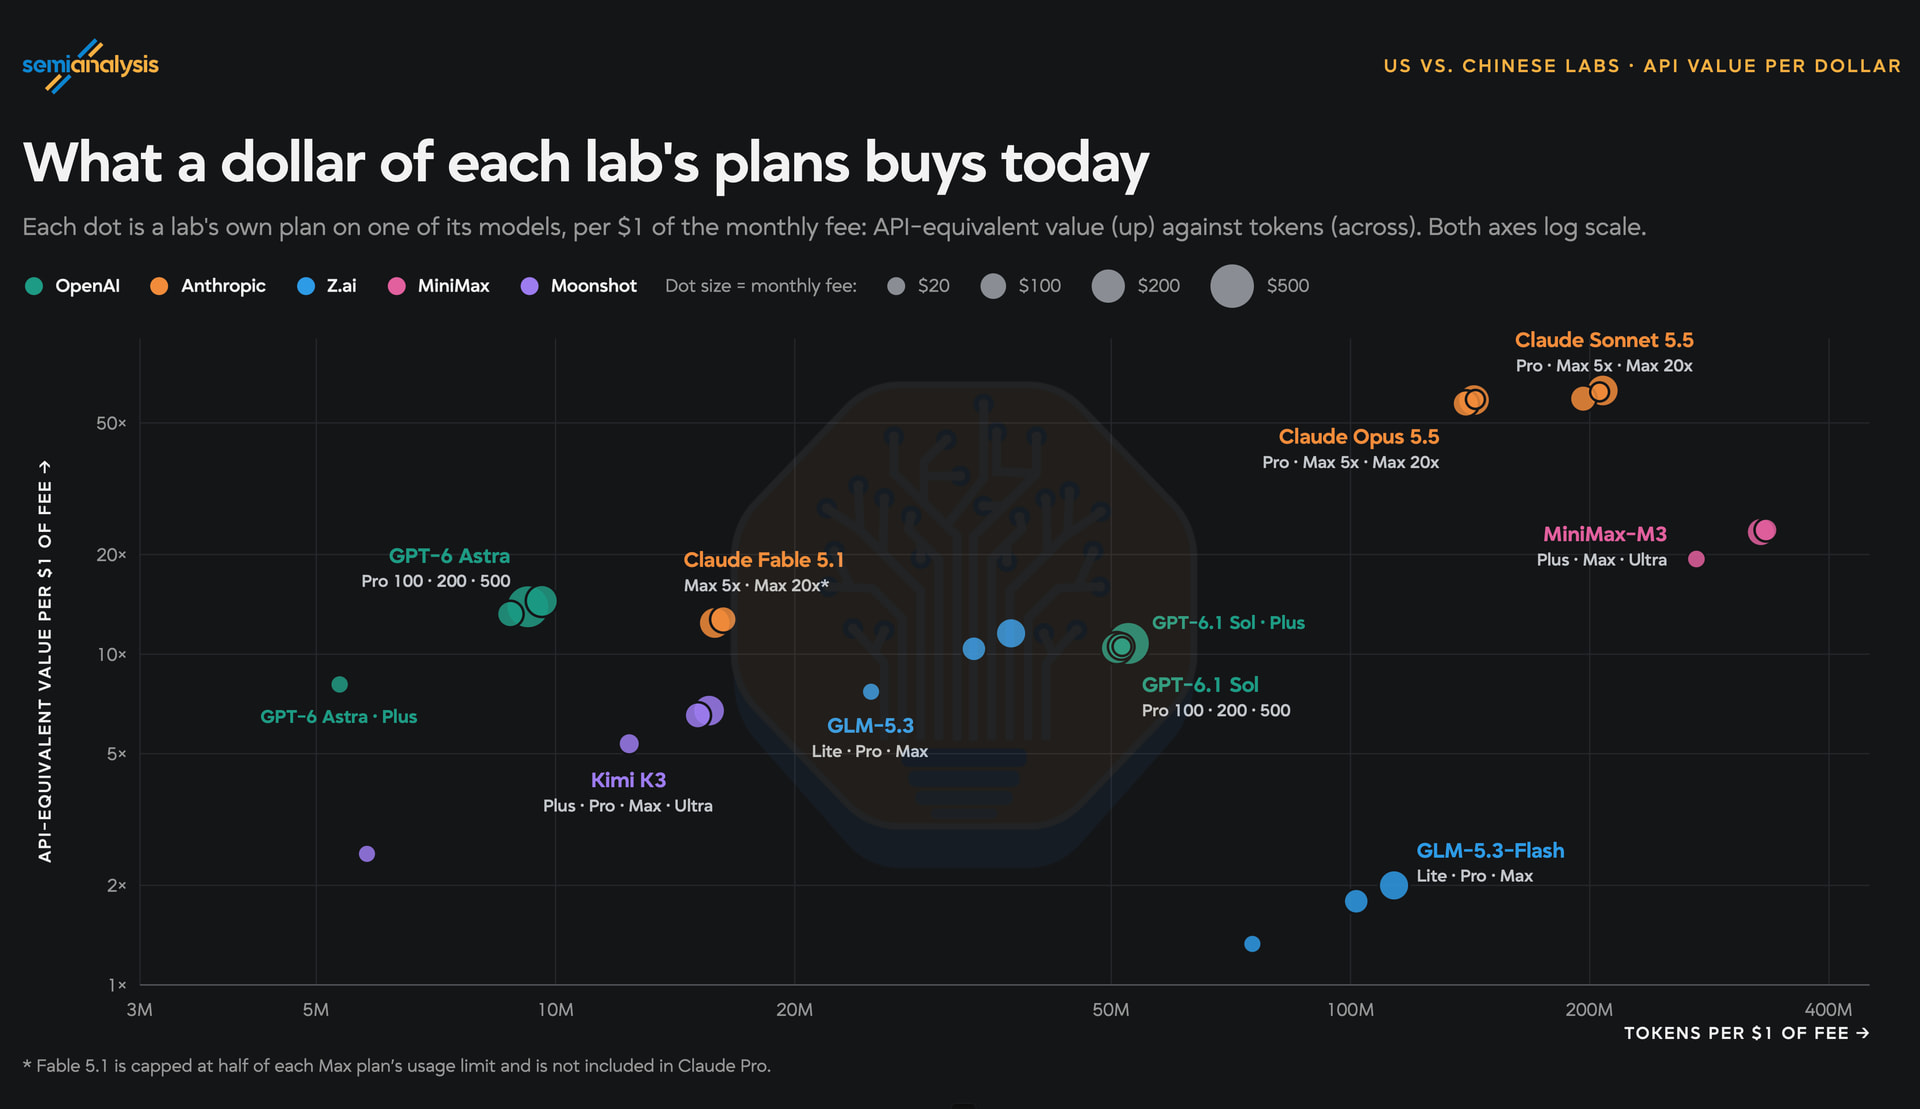
所提供图片署名为 SemiAnalysis。每个点代表一家模型厂商自己的订阅方案与一个模型的组合,两个坐标轴均为对数刻度。这不是 OpenCode Go 的套餐比较,图片也没有标明测量日期。
这张图也提醒我们,不能直接沿用笼统的 35–50 倍估算。图中的 GPT-6.1 Sol 大约在 10 倍附近,Claude Sonnet 5.5 和 Opus 5.5 超过 50 倍,MiniMax M3 则在 20 倍左右。没有一个统一倍率能概括所有 GPT/Claude 套餐,国产模型订阅的价值倍率也不是一概偏低。这些是图表给出的估算,不是我们独立复现的测量结果。具体厂商、模型和订阅档位都需要分开看。
不同模型的一美元 API 等效价值,也不代表同样多的有效工作。API 本身定价更贵,可能让套餐倍率看起来更高,却没有增加实际能完成的任务。在之前的 token 方案文章里,我们更关注 API 等效预算。这次试用让我们把重点放回一个更简单的问题:这个订阅究竟能支持多少我们真正需要做的任务?
不只是继续加钱
最让人失望的是,我们愿意为能力强的海外模型付费,却要面对账号封禁和服务质量不确定性。转向国产模型,目前尝试的选项又没有给出我们想要的价格与能力组合。这里说的是自己的测试范围,不是对整个市场下结论。
这也解释了为什么「把强模型用好」有时会变成一个专门的角色。访问条件、任务选择、上下文准备和结果验证,都会影响一个团队从订阅里获得多少有效工作。操作者的价值不只是输入 prompt,而是知道什么值得交给模型,什么地方仍然需要人来带领。
因此,我们已经减少了 token 使用量。这与如果 AI 属于我们,它的能力也属于我们吗?里的问题是连在一起的:生成出来的内容,不会自动变成自己的理解。
文件可以属于我们,但背后的推理仍然留在模型那里。如果一个重要修改,我们无法解释、无法验证,也无法在模型消失之后维护,那么得到的是输出,不是同等程度的能力。这不代表输出没有价值,而是说明依赖确实存在。
即便使用 Claude 和 GPT,人也没有因此变得不重要。问题怎么选、证据怎么判断、关键决策怎么理解,仍然需要自己参与。更多 token 可以加快产出,却不能保证我们更擅长这份工作。
也许,这套想法确实有一部分是在安慰自己:接受暂时无法稳定使用又便宜又强的模型。这个可能性应该承认。预算更紧依然是限制,不是什么隐藏优势。 但就算访问和额度完全没有问题,生成更多与理解更多之间的区别,仍然成立。
结论
这次 67 元的 Go 试用,没有得到我们期待的廉价 Kimi 日常工作流。按观察到的消耗,月度预算大约支持二十个中等复杂度 issue;GPT Plus 的四周粗略外推则约为四百个。按用满配额摊销,单任务成本约为 3.35 元和 0.335 元。
核对后的 Go 相关模型额度倍率为 1.5–8 倍。我们对 GPT/Claude 的 35–50 倍估算尚未得到证实,提供的图表也说明这些模型和套餐需要分开比较。更可靠的结论是:模型 API 单价看起来便宜,订阅方案却未必能让自己的日常任务变便宜。
接下来,我们会按通过验收的实际任务成本选择模型,保留可迁移的替代工具,也减少那些没有增加多少价值的生成。目标不是用掉尽可能多的配额,而是用可持续的价格完成工作,并保留足够的理解,真正掌握结果。